La lettre hebdomadaire de Café IA |
|
| |
|
Bonjour à tous.tes,
Nous sommes le vendredi 5 juin 2026. Au menu de cette 34e édition de la lettre Café IA nous revenons à notre série sur les imaginaires de l’IA en nous attaquant à un nouveau chapitre : les promesses de l’IA ✦ Dans la veille on décortique l’évolution des usages de l’IA et les limites des podcasts génératifs ✦ La ressource de la semaine revient sur un nouveau jeu de plateau : Numéville ✦ Et comme chaque semaine, retrouvez toute l’actualité de la communauté Cafés IA … Bonne lecture ! |
IA, des promesses aux réalités |
L’intelligence artificielle fait beaucoup de promesses qui ancrent un imaginaire très prégnant sur ce qu’elles peuvent et pourraient accomplir. En réalité, il est bien souvent nécessaire de déconstruire ces promesses, en comprenant qu’elles masquent des idéologies qui les dépassent et ancrent des perspectives partiales et partielles. Derrière les espérances que portent l’IA, il faut à la fois interroger ce que ces IA font vraiment et au bénéfice de qui. Pour déconstruire les imaginaires de l’IA, il est donc nécessaire d’interroger certaines de ses plus vives promesses : l’efficacité, l’objectivité, la prédictibilité, la productivité, le contrôle, et la créativité. Autant de promesses d’opérationnalité d’une neutralité technique et scientifique, par nature inatteignable.
|
La sempiternelle promesse d’efficacité |
Parmi les nombreux symboles de la promesse d’efficacité du déploiement de l’IA, il en est un qui a peut-être marqué les esprits plus que d’autres, c’est celui du Département de l'efficacité gouvernementale (Doge) [1] une organisation temporaire fondée aux États-Unis par le président Trump en janvier 2025 et, un temps « dirigée [2] » par l’entrepreneur multimilliardaire Elon Musk. Le terme de Doge fait également référence à une cryptomonnaie (rachetée par Musk d’ailleurs) ainsi qu’à un mème récurrent d’internet, relative à un chien shiba, dont la signification, évolutive, est « dépourvue de logique ou de sens profond [3] ». Le sourire énigmatique du shiba est venu illustrer autant l’indifférence que l’ironie ou l’absurdité de la démarche. L’image du Doge est venue symboliser la politique mise en place par Musk, à la fois d’une manière ironique et subversive. En plaçant au cœur de son action politique la question de l’efficacité, le Doge a permis de questionner l’omniprésence de cette promesse d’efficacité dans le marketing de l’IA.
L’efficacité pour le Doge a en effet été circonscrite à la seule réduction des coûts des services publics, qu’il faudrait donc « tronçonner [4] » pour les réduire. Or, la question de l’efficacité renvoie toujours à la question de l’objectif poursuivi et à l’angle sous lequel on le regarde, c’est-à-dire depuis quel indicateur (au détriment de tous les autres). Mais ni les coupes budgétaires, ni la lutte contre la fraude, ni le licenciement de fonctionnaires ne signifient pour autant produire de l’efficacité [5]. Dans le cadre du Doge américain, le licenciement des fonctionnaires pour faire des économies et leur remplacement par des programmes d’IA fait une promesse d’efficacité supputée, mais a surtout pour objectif de rendre le changement à l'œuvre sans recours, en éliminant la résistance des corps institués aux transformations des services. Dans le cadre du Doge, le but a visé bien plus à réduire les dépenses pour des raisons politiques que de les réduire depuis des preuves de fraudes, d’abus ou d’efficacité économique. C’est ce qui explique que la mission du Doge se soit évanouie peu à peu. Reste que la promesse, elle, est restée. Si le Doge a disparu de l’actualité, ce n’est pas le cas de ses actions ni du modèle. Aux États-Unis, des « missions d’efficacité », inspirées du Doge, se sont démultipliées dans de nombreux États et administrations [6]. On pourrait même dire que les actions du Doge, à introduire des outils d’IA pour exercer des fonctions étatiques fondamentales et mettre fin au cloisonnement des données des administrations américaines a finalement bénéficié non pas au Doge lui-même, mais à d’autres administrations, notamment l’ICE, la police de l’immigration et des douanes, qui est devenue l’agence fédérale la mieux financée des Etats-Unis. Elle n’en a pas bénéficié pour faire des économies, mais au contraire, pour poursuivre une politique de répression des personnes d’origines étrangères [7].
Cette histoire symbolique nous montre que l’efficacité est souvent une notion instrumentée. La question de « l’efficacité » est une question qui traverse l’IA et qui nous est toujours proposée comme un moyen pour en produire plus, oubliant d’interroger de quelle efficacité nous parlons, vue depuis quel point de vue. Or, l’efficacité est toujours située [8], elle agit sur un critère au détriment d’autres. Dans le domaine de la santé par exemple, on nous explique souvent que les systèmes de détection par IA fonctionnent mieux que les spécialistes, détectent des tumeurs plus tôt ou en faisant moins d’erreurs que ceux-ci. Mais ces scores élevés ont tendance à identifier des tumeurs de plus en plus bénignes et donc à augmenter le taux de patients à traiter au risque de développer des coûts de santé injustifiés [9].
Cela rappelle à nouveau que l’efficacité des systèmes est toujours à interroger. Le développement du diagnostic automatisé ne vise pas seulement à améliorer la précision de la médecine, elle peut aussi la déborder. Et surtout, elle ne s’évalue pas indépendamment d’autres critères, par exemple : les coûts, le manque de personnel et les défaillances des systèmes de santé… qui ne sont pas pris en compte dans l’équation de la seule efficacité des systèmes d’analyses d’images de radiologie.
Bref, l’équation de l’efficacité à tendance à valoriser un enjeu en en invisibilisant tous les autres, nous faisant oublier que cette efficacité est toujours localisée, orientée, défend toujours certains enjeux et certains intérêts au détriment d’autres, qu’elle est toujours celle de celui qui l’invoque depuis l’angle par laquelle il l’invoque. Ainsi, la promesse que l’IA permettra de faire des progrès en médecine ou dans nombre d’autres domaines est toujours répétée pour justifier des investissements, mais bien peu démontrée. En vérité, les progrès demeurent surtout incrémentaux et lents et ne pourront pas être effectifs, si le système de soin, lui, s’effondre. Pour le dire autrement, le progrès et l’efficacité médicales ne sont pas qu’une question d’innovation technique, mais également de disponibilité d’une infrastructure de soins pour tous [10]. En n’observant l’IA que comme un progrès, on ne discute pas de toutes les transformations qu’elle induit qui n’en relèvent pas et qui favorisent le pouvoir de quelques-uns sur tous les autres.
Pour le dire plus simplement encore, derrière le terme d’efficacité ne se cachent pas que des processus à optimiser, mais bien des pouvoirs qui s’affrontent. L’efficacité des uns cache toujours l’impuissance imposée aux autres. |
|
|
|
Compas, le logiciel de prédiction de risque de récidive criminel américain [11], utilisé dans de nombreuses juridictions de l’autre côté de l’Atlantique, est assurément l’un des emblèmes de la pseudo « objectivité » des calculs et donc de leurs défaillances du fait des biais [12] qu’ils embarquent. La promesse d’objectivité de cette prédictibilité nous fait oublier que les calculs ne sont jamais neutres : ils produisent toujours des décisions orientées selon les critères depuis lesquels ils sont construits, les objectifs qu’ils visent et les données avec lesquelles ils sont nourris.
Le calcul de risque [13] de récidive de Compas s’appuie sur un questionnaire comportant plus de 110 questions auxquelles doivent répondre les assistant.e.s sociaux qui accompagnent les personnes condamnées. Ces questions et surtout leurs réponses estiment que le risque de récidive serait inhérent aux caractéristiques individuelles des individus, à leur histoire, à leur parcours, à leur identité, plutôt qu’à des conditions socio-économiques exogènes. Le traitement de ces réponses par le logiciel donne un résultat augmenté d’un code couleur qui prédit le risque de récidive violente. Celui-ci est imprimé et ajouté au dossier et les magistrats le consultent pour prendre leurs décisions. Il se présente donc bien comme un outil d’aide à la décision opaque, biaisé et performatif [14] qui optimise une forme de décision sur d’autres [15]. Le calcul de risque de récidive de Compas a été dénoncé par nombre d’organisations et de chercheurs comme étant particulièrement biaisé au détriment des personnes de couleurs, déjà malmenées par le système judiciaire américain [16].
Tous les systèmes de calculs de risque déployés dans les domaines du social ont montré des défaillances problématiques, des algorithmes d’atténuation des risques bancaires à ceux de recherche de fraudes de la CAF [17].
Dès que nous tentons d’utiliser l’IA pour des prédictions, notamment dans le domaine du social, elle produit des discriminations. De l’emploi à la santé, en passant par le crime… Partout ces modèles restent englués dans leurs biais [18], en produisant des résultats assez pauvres. Trop souvent, ces systèmes de prédiction des risques utilisent des proxies, des variables substitutives qui nous font croire qu’on peut mesurer une chose par une autre, comme les coûts de la santé plutôt que les soins [19] où les risques de récidives criminelles depuis des données sur l’emprisonnement des proches.
Les outils de prédiction, derrière leur apparente neutralité et leur volonté de scientificité, amplifient les biais qu’ils véhiculent. En 2018, une enquête de Reuters [20] avait montré que le système de recrutement d’Amazon était fortement biaisé au détriment des femmes : ses données d’entraînement (les CV des gens déjà recrutés par Amazon) comportaient trop peu de femmes et le système écartait les candidates par défaut. Malgré les tentatives de l’équipe d’Amazon pour réparer le système d’embauche, l’équipe a fini par abandonner le projet, faute d’y parvenir. C’est dire que réparer les défaillances et les biais n’est pas si simple. L’exemple montre bien que pour corriger les biais, encore faut-il pouvoir les mesurer ou déterminer quelles corrections appliquer [21]. La neutralité des calculs n’est donc pas tant un problème technique à corriger, une question de modélisation à ajuster, de données à élargir ou de calculs à améliorer. Elle consiste au contraire à reconnaître que nos calculs sont situés et défaillants, et à trouver des solutions qui ouvrent des perspectives plutôt qu’elles ne les referment pour ceux qui sont impactés par les calculs. « Les biais sont la nature même des classifications » disait Kate Crawford [22].
La promesse d’objectivité est également une promesse de neutralité, celle d’une science des données et des traitements « qui pense être capable de produire le monde sans avoir à le convoquer » [23], et auquel il suffirait d’appliquer une froide raison sur le calcul pour neutraliser ce qu’il produit. Comme le dit l’historien des sciences Theodore Porter, « la quantification est une technologie de la distance », c’est-à-dire qui met à distance sous principe d’objectivité. La neutralité en est l’idéal, qui promeut un point de vue surplombant, oubliant qu’il constitue surtout le point de vue du groupe dominant, au détriment des contextes, de la diversité des situations. Oubliant que la connaissance se construit bien plus par la diversité des perspectives que par le rejet de certaines, ou par la prise en compte des incertitudes que par l’affirmation qu’il n’y en aurait aucune. Le narratif sur l’objectivité de l’IA sert à opacifier ses effets, explique Dan McQuillan [24]. Il nous pousse à croire que l’optimisation statistique serait le summum de la rationalité, qu’il permettrait d’éliminer nos biais quand il ne fait que les accélérer. Pour Couldry et Mejias, l’IA sert surtout à dissimuler les limites de la rationalité, à la parer de neutralité et à automatiser la violence et la discrimination qu’elle produit [25]. Pour le dire autrement, l’IA n’est que la nouvelle étape d’une production coloniale ou impériale de connaissances qui prend toutes les productions humaines pour générer un savoir qui nous est présenté comme son apothéose, quand elle est avant tout un moyen d’assurer la continuité de son appropriation par certains au détriment de tous.
|
Notes :
[1] En anglais, Department of Government Efficiency (Doge). https://fr.wikipedia.org/wiki/D%C3%A9partement_de_l%27Efficacit%C3%A9_gouvernementale
[2] Le « département » non officiel n’a jamais été dirigé par Elon Musk mais par Amy Gleason. Musk n’en a été que le conseiller de janvier à mai 2025, même si ce sont ses équipes et visiblement lui, qui a dirigé pendant les 6 premiers mois les actions du Doge. Le terme de département correspond à ce que nous appellerions un ministère, mais, malgré son nom, le Doge n’a pas été un véritable ministère puisque sa création aurait nécessité l’approbation du Congrès américain, ce qui n’a pas été le cas.
[3] A l’image du terme lui-même, concaténation du terme Dog (chien) auquel est ajouté un « e » qui ne signifie rien et rend le mot absurde. Voir la définition du mème Doge sur Wikipédia : https://fr.wikipedia.org/wiki/Doge_(m%C3%A8me) ainsi que Pierre Trouvé, « Mort de Doge, le chien devenu l’un des mèmes les plus connus d’internet », Le Monde, 24 mai 2024 : https://www.lemonde.fr/pixels/article/2024/05/24/mort-de-doge-le-chien-devenu-l-un-des-memes-les-plus-connus-d-internet_6235237_4408996.html
[4] Sur le modèle du programme du président ultralibéral argentin Javier Milei dont la tronçonneuse est devenue l’emblème des coupes drastiques accomplies dans les services publics.
[5] Hubert Guillaud, « Doge : l’efficacité, vraiment ? », Danslesalgorithmes.net, 4 mars 2025 : https://danslesalgorithmes.net/2025/03/04/doge-lefficacite-vraiment/
[6] Voir notamment, Hubert Guillaud, « Après le Doge, les Doges ! », Danslesalgorithmes.net, 15 octobre 2025 : https://danslesalgorithmes.net/2025/10/15/apres-le-doge-les-doges/
[7] Hubert Guillaud, « Doge : la fin du cloisonnement des données » Danslesalgorithmes.net, 13 mai 2025 : https://danslesalgorithmes.net/2025/05/13/doge-la-fin-du-cloisonnement-des-donnees/ Michael Macher, « Wages of Citizenship », 10 avril 2025 : https://phenomenalworld.org/analysis/wages-of-citizenship/
[8] Donna Haraway, Savoirs situés, Wildproject, 2026.
[9] La neurologue irlandaise, Suzanne O’Sullivan, auteure de The Age of Diagnosis: Sickness, Health and Why Medicine Has Gone Too Far (Penguin Random House, 2025), estime que l’essor technologique nous permet désormais d’améliorer les diagnostics. Mais, tempère-t-elle, cet essor « ne semble pas s’être accompagné d’une amélioration de notre santé ». Si nous détectons et traitons davantage de cancers à des stades plus précoces, ce qui sauve la vie de certaines personnes, en revanche, d’autres reçoivent des traitements inutiles, et il se pourrait que la proportion des personnes surtraitées soit plus forte que la réduction de la mortalité. En fait, des études à grande échelle montrent que l’amélioration du dépistage ne conduit pas à une amélioration des taux de survie. La spécialiste dénonce une dérive diagnostique. Nos outils sont devenus plus précis, au risque de générer d’innombrables faux-positifs.
[10] Voir notamment Alexandre Monnin, « Ne plus soigner : une tendance actuelle », AOC, 12 juin 2025 : https://aoc.media/analyse/2025/06/11/ne-plus-soigner-une-tendance-actuelle/
[11] Développé par la société Northpointe devenue Equivant, Compas est un acronyme pour « Correctional Offender Management Profiling for Alternative Sanctions » pour désigner un outil de Gestion de profilage de sanctions alternatives pour délinquants en correctionnel :
https://en.wikipedia.org/wiki/COMPAS_(software)
[12] Le terme de « biais » fait référence au phénomène selon lequel les algorithmes produisent des distorsions faussant la neutralité et l’objectivité des résultats. Ces biais peuvent provenir autant des données utilisées qui ne sont pas toujours représentatives (par exemple sur des facteurs tels que l'appartenance ethnique, le sexe ou d'autres caractéristiques sociaux-démographiques comme le niveau de revenus, l’âge…) ainsi que selon les modalités d’agencement, de traitement ou de calculs, pouvant conduire à des traitements injustes et à renforcer ou faire perdurer les inégalités sociales.
[13] Le calcul de risque d’erreurs, de fraudes, d’abus, d’indus… sont des techniques de production statistiques nées dans les domaines de l’assurance, de la banque et de la téléphonie mobile pour identifier les erreurs, fraudes et abus. Elles sont désormais également très utilisées dans nombre d’autres domaines du social, comme l’emploi, les impôts, la sécurité sociale pour déclencher des contrôles. Leur principe consiste à extraire des dossiers identifiés comme porteurs de risques pour produire des critères et variables qui les caractérisent, puis d’appliquer ces éléments à l’ensemble des cas pour que les systèmes signalent automatiquement les dossiers qui s’en rapprochent et ainsi limiter les risques avant qu’ils ne surviennent. Cf. Vincent Dubois, Contrôler les assistés, genèses et usages d’un mot d’ordre, Raisons d’agir, 2021 ainsi que Hubert Guillaud, « Le calcul de risque, cette révolution industrielle de l’administration publique produite à notre insu », InternetActu.net, 22 juin 2021 : https://www.internetactu.net/2021/06/22/le-calcul-de-risque-cette-revolution-industrielle-de-ladministration-publique-produite-a-notre-insu/ Voir aussi Jathan Sadowski, The Mechanic and the Luddite : a ruthless criticism of technology and capitalism, University of California Press, 2025.
[14] Ces systèmes sont opaques parce que les modalités de leurs fonctionnements ne sont pas documentées ni publics et parce que les scores que les calculs produisent ne sont pas communiqués aux prévenus et que ceux-ci ne disposent d’aucune modalité pour les contester. Ils sont biaisés car nombres de variables utilisées sont reliées à l’appartenance ethnique, que ce soit par le biais de questions formelles simples, comme l’indication du code postal, ou par le biais de questions plus complexes, comme les relations familiales. Ils sont biaisés également parce qu’ils entérinent et renforcent l’inégalité sociale de la justice américaine qui incarcère les noirs et les pauvres plus massivement que d’autres catégories de population. Enfin, ils sont performatifs, parce qu’en cherchant des récidivistes potentiels, ils en créent. Pour la chercheuse Angèle Christin, ces outils ne sont « ni neutres, ni impartiaux, ni objectifs, ni efficaces ». Voir par exemple : Angèle Christin.« Algorithms in Practice: Comparing Web Journalism and Criminal Justice. » Big Data & Society, 2017 : https://journals.sagepub.com/doi/pdf/10.1177/2053951717718855
[15] D’autres systèmes concurrents à Compas ont été élaborés. Par exemple un système qui propose pour chaque prévenu la meilleure solution pour qu’il ne récidive pas où se présente au tribunal, en recommandant pour chacun les aides les mieux adaptées plutôt que de chercher à les empêcher de sortir de prison du fait du risque que le système leur attribue. Un autre système, ESAS, propose lui de ne pas donner accès aux juges un score de risque pour chaque prévenu – dont ils suivent trop souvent les recommandations, mais plutôt un logiciel qui leur donne accès aux peines similaires prononcées dans des affaires antérieures selon des antécédents de condamnations proches, leur permettant de comparer leur sentence et de relativiser leurs jugements.
[16] Julia Angwin, Jeff Larson, Surya Mattu and Lauren Kirchner, « Machine Bias », ProPublica, May 23, 2016 : https://www.propublica.org/article/machine-bias-risk-assessments-in-criminal-sentencing Gaston Bidou, Quentin Hillebrand, Zhanbo Hu, Hugo Pouzet, Justine Rayssac, Raphaël Rozenberg, Jianan Shi, Morgane Turlan, « Compas, un outil impartial ou biaisé ? », Les controverses de Mines Paris, 2022 : https://controverses.minesparis.psl.eu/public/promo21/COMPAS.pdf Valérie Beaudouin et Winston Maxwell, « La prédiction du risque en justice pénale aux Etats-Unis : l’affaire propublica-Compas », Revue Réseaux, 2023/4, n°240 : https://shs.cairn.info/revue-reseaux-2023-4-page-71 Hubert Guillaud, « Vers la justice analytique (2/3) : prédiction et régulation en leurs limites », InternetActu.net, 24 juillet 2017 : https://www.internetactu.net/2017/07/24/vers-la-justice-analytique-23-prediction-et-regulation-en-leurs-limites/
[17] Sur les limites des outils d’atténuation de risque bancaire, voire notamment la série de podcasts produite par l’AFP et Algorithm Watch, « Faux positifs », janvier 2025 : https://podcasts.afp.com/afp-audio-sur-le-fil/202503110400-comprendre-les-fermetures-abusives-de-comptes-en-banque-redi. Sur les algorithmes de la CAF, voir les travaux de l’association Changer de Cap : https://changerdecap.net. Ainsi que Gabriel Geiger, Soizic Pénicaud, Manon Romain et Adrien Sénécat, « Profilage et discriminations : enquête sur les dérives de l’algorithme des caisses d’allocations familiales », Le Monde, 4 décembre 2023 : https://www.lemonde.fr/les-decodeurs/article/2023/12/04/profilage-et-discriminations-enquete-sur-les-derives-de-l-algorithme-des-caisses-d-allocations-familiales_6203796_4355770.html. Nous invitons également à se référer aux travaux pionniers de Virginia Eubanks, Automating Inequality, MacMillan, 2018.
[18] Comme l’expliquent les chercheurs Arvind Narayanan et Sayash Kapoor dans AI Snake Oil, Princeton University Press, 2024. Pour eux, on pourrait utiliser deux données seulement pour produire un outil qui donnerait des résultats « aussi précis » que celui de Compas : l’âge et le nombre d’infractions antérieures. Dans le cas de la récidive, le modèle est assez simple : plus l’âge est bas et plus le nombre d’infractions antérieures est élevé, plus la personne sera à nouveau arrêtée. On pourrait d’ailleurs n’utiliser que le nombre d’infractions antérieures pour faire la prédiction sans que les résultats ne se dégradent vraiment (qui serait moralement plus acceptable car en tant que société, on pourrait vouloir traiter les plus jeunes avec plus d’indulgence). L’avantage d’une telle règle, c’est qu’elle serait aussi très compréhensible et transparente, bien plus que l’algorithme opaque de Compas.
[19] Les outils de prédiction de risque de santé, déployés pour réduire les dépenses d’hospitalisation, ont surtout montré leurs biais à l’encontre des minorités. L’un de ces outils, Optum’s Impact Pro par exemple, écartait systématiquement les personnes noires, parce que le système ne prédisait pas tant le besoin de soins, que combien l’assurance allait dépenser en remboursement des soins de santé. L’entreprise a continué d’ailleurs à utiliser son outil défaillant, même après qu’il ait montré son inéquité. « Les intérêts des entreprises sont l’une des nombreuses raisons pour lesquelles l’IA prédictive augmente les inégalités. L’autre est la trop grande confiance des développeurs dans les données passées. » Ces systèmes reposent sur des préjugés omniprésents, par exemple, dans les systèmes qui priorisent les arrivées aux urgences ou ceux qui tentent d’identifier les patients qui ne se présentent pas à leurs rendez-vous. Les chercheurs parlent de « problème systémique », pour expliquer que la neutralité est un objectif difficilement atteignable et qui nécessite une attention constante. Hubert Guillaud, « En médecine, l’IA est en plein essor, mais pas crédibilité », InternetActu.net, 3 juin 2021 : https://www.internetactu.net/a-lire-ailleurs/en-medecine-lia-est-en-plein-essor-mais-pas-sa-credibilite/ Ainsi que David Robinson, Voices in the code, a story about people, their values, and the algorithm they made, Russell Sage Foundation, 2022.
[20] Jeffrey Dastin, « Amazon scraps secret AI recruiting tool that showed bias against women », Reuters, 11 octobre 2018 : https://www.reuters.com/article/idUSKCN1MK0AG/
[21] Catherine D’Ignazio et Lauren Klein dans leur livre Data Feminism (MIT Press, 2020), estiment que parler de biais laisse croire qu’on pourrait les corriger : elles préfèrent donc parler d’oppression. Même constat chez d’autres auteurs comme Sasha Constanza-Chock dans Design Justice : community-led practices to build the worlds we need (MIT Press, 2020), ou Ruha Benjamin dans Race after technology (Polity, 2019)… qui parlent elles plutôt de justice, pour pointer également l’importance des rapports de pouvoir masqués par les traitements.
[22] Kate Crawford, Contre-Atlas de l’intelligence artificielle, Zulma, 2021.
[23] Lauren Klein et Catherine D’Ignazio, Data Feminism, MIT Press, 2020. Ainsi que Hubert Guillaud, « Pour un féminisme des données », 09 juillet 2024 : https://danslesalgorithmes.net/2024/07/09/pour-un-feminisme-des-donnees/
[24] Dan McQuillan, Resisting AI : An Anti-fascist Approach to Artificial Intelligence, Bristol University Press, 2022.
[25] Ulises A. Mejias et Nick Couldry, Data Grab : the new colonialism of Big Tech (and how to fight back), WH Allen, 2024. |
📆Agenda et actualités de Café IA |
|
|
|
🎨📰 Semaine de l’IA pour tous : à la une |
Un immense merci à tous les participants, organisateurs, animateurs qui ont fait vivre la Semaine de l'IA pour Tous partout en France. C'est grâce à votre engagement que cette semaine a pris une telle ampleur.
Et cet engagement ne passe pas inaperçu ! La semaine a bénéficié d'une large couverture dans la presse régionale et nationale, ainsi que sur les réseaux sociaux. Ce sont plus de 140 articles qui ont parlé de vous et de vos initiatives. En voici quelques extraits : |
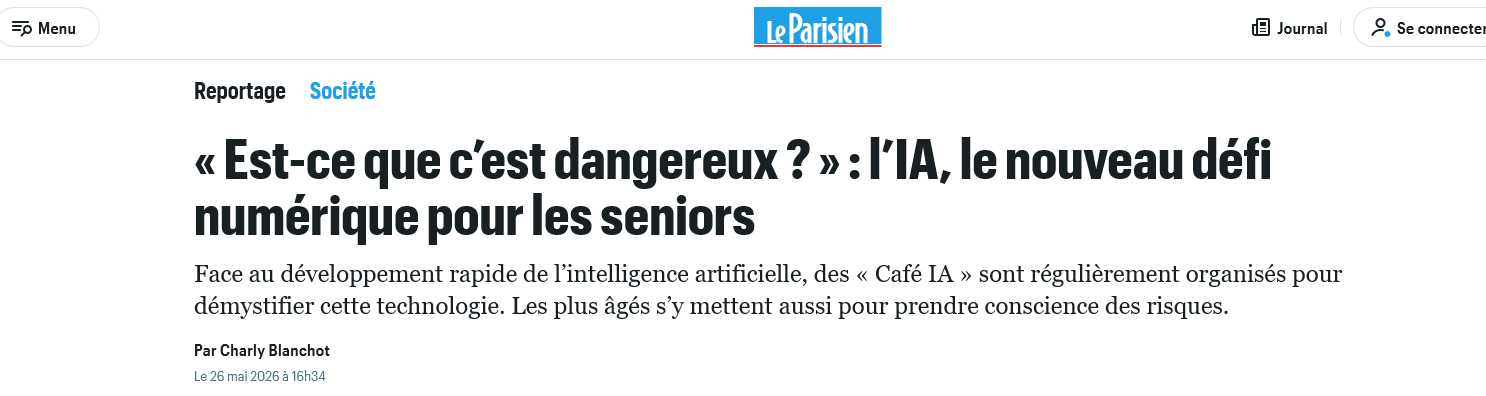
« De son côté, Daniele reconnaît utiliser cette technologie pour des questions simples. « Pour le mariage de ma fille, j'ai même demandé de l'aide à ChatGPT pour rédiger mon discours », confie-t-elle. À la fin de cet atelier ludique, Gérard repart rassuré. « L'IA, il ne faut pas en avoir peur. On connaît maintenant les limites à ne pas franchir », se réjouit le retraité de 70 ans. » Le Parisien, le 26 mai 2026
« Pour Christine Kornprobst, chargée de clientèle France services à La Poste de Patrimonio, cette proximité fait toute la différence. « Beaucoup de personnes entendent parler de l’intelligence artificielle sans vraiment savoir ce qu’elle peut leur apporter. Notre rôle, ici, c’est justement de rendre ces outils compréhensibles et rassurants, avec des exemples très concrets du quotidien. ». » Corse Net Infos, le 26 mai 2026
« Le dispositif Café IA vise à créer un véritable maillage national d’espaces de dialogue sur l’intelligence artificielle, dans des lieux du quotidien : médiathèques, mairies, associations et bureaux de poste depuis 2025…La Poste réaffirme sa volonté d'ouvrir l'accès au numérique au plus grand nombre. « Une démarche nécessaire au vu des fortes disparités à combler » explique Anne Le Hénanff, ministre déléguée chargée de l'intelligence artificielle et du numérique. » Groupe La Poste, le 21 mai 2026
« Une occasion idéale pour les habitants d'Ardizas et des alentours de comprendre les opportunités offertes par l'IA, que ce soit dans la vie quotidienne, professionnelle ou pour le développement local, mais aussi d'aborder les limites et les risques potentiels liés à son utilisation (protection des données, biais, confidentialité, transparence). » La Dépêche du Midi, le 18 mai 2026
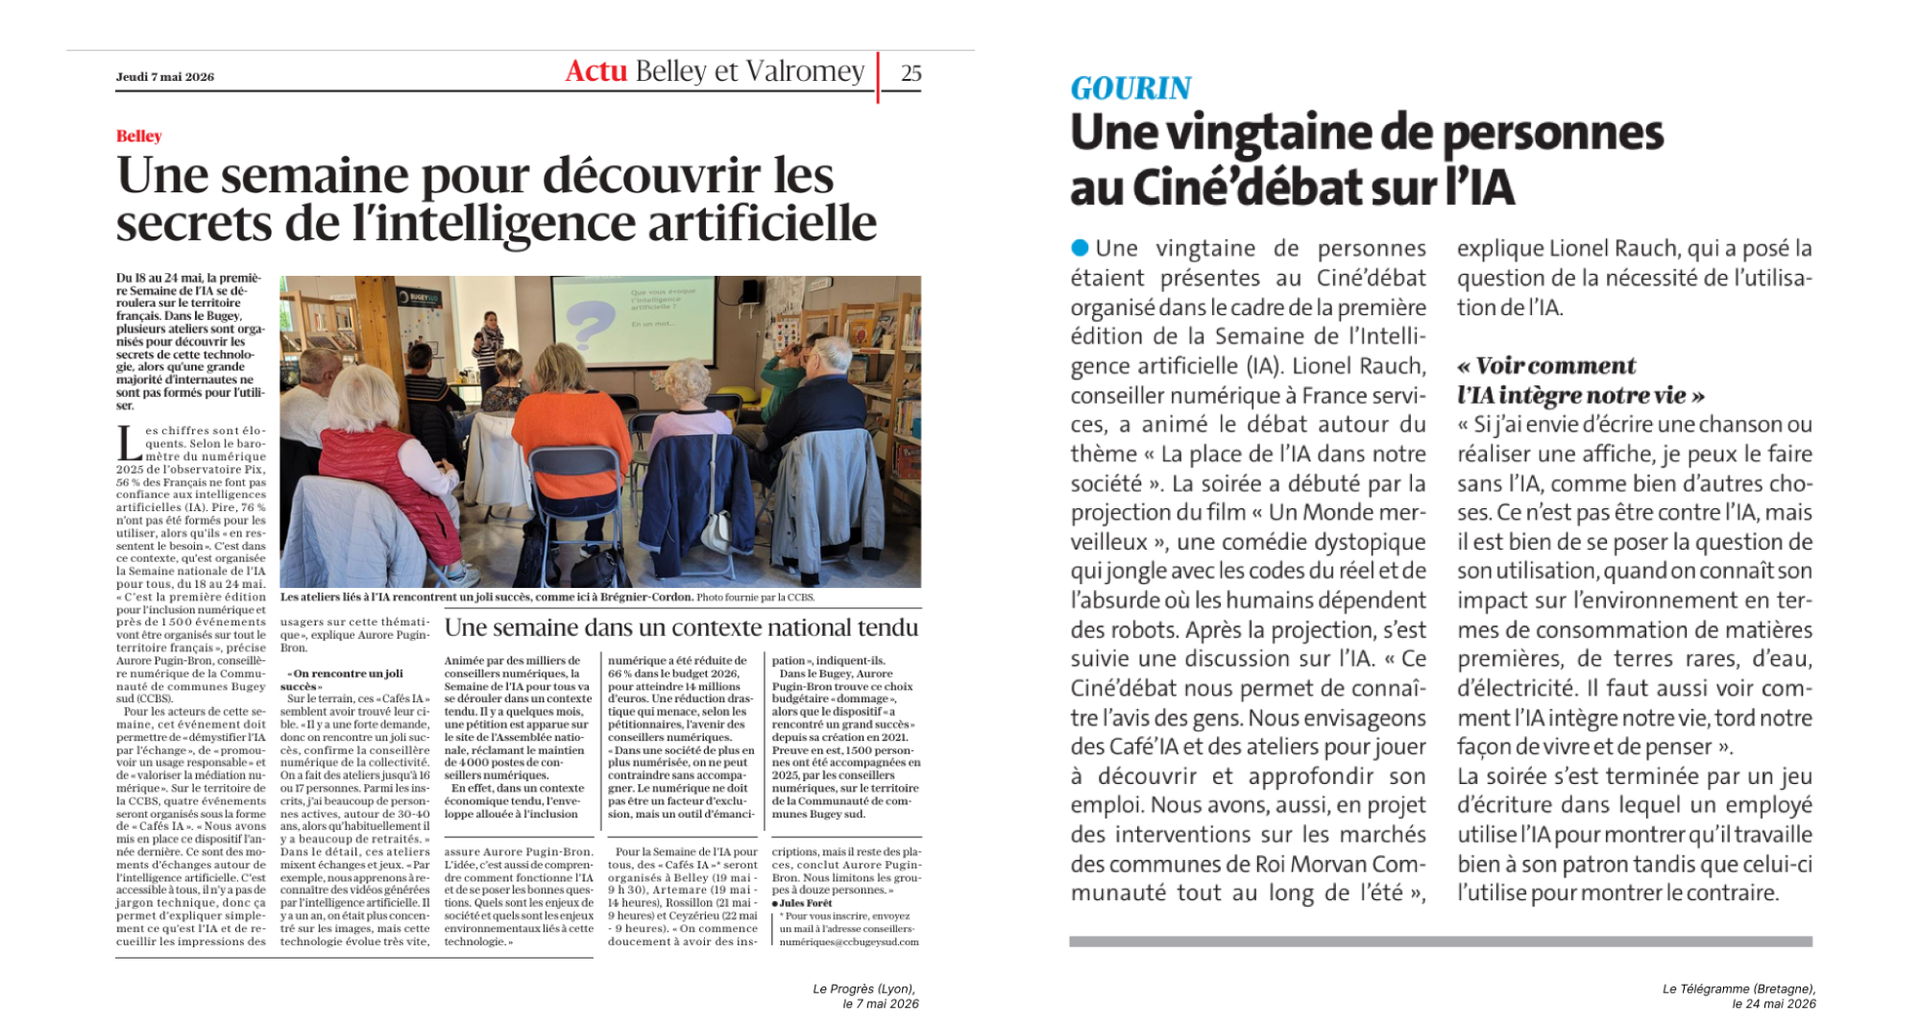
Lionel Rauch : « Si j’ai envie d’écrire une chanson ou réaliser une affiche, je peux le faire sans l’IA, comme bien d’autres choses. Ce n’est pas être contre l’IA, mais il est bien de se poser la question de son utilisation, quand on connaît son impact sur l’environnement en termes de consommation de matières premières, de terres rares, d’eau, d’électricité. Il faut aussi voir comment l’IA intègre notre vie, tord notre façon de vivre et de penser ». Le Télégramme (Bretagne), le 24 mai 2026
|
« Sur le terrain, ces « Cafés IA » semblent avoir trouvé leur cible. « Il y a une forte demande, donc on rencontre un joli succès, confirme la conseillère numérique de la collectivité. On a fait des ateliers jusqu’à 16 ou 17 personnes. Parmi les inscrits, j’ai beaucoup de personnes actives, autour de 30-40 ans, alors qu’habituellement il y a beaucoup de retraités. » Dans le détail, ces ateliers mixent échanges et jeux. » Le Progrès (Lyon), le 7 mai 2026
« Orange, LinkedIn, Éducation nationale : des engagements concrets. Les partenaires ne se contentent pas d’afficher un logo. Chacun apporte en effet sa pierre à l’édifice. Lors du lancement officiel ce mardi, une table ronde a d’ailleurs permis de découvrir plus en détail comment cet engagement se concrétise. » Paroles d’Élus, le 22 mai 2026 |
⌚️ Les Cafés IA à venir ! |
Les Cafés IA à venir : - Le 5 juin à Joué-sur-Erdre, un Café IA propose un temps d’échange pour mieux comprendre l’intelligence artificielle et ses usages du quotidien.
-
Le 5 juin à Martigues, le Café IA : Actualités autour de l’IA invite à découvrir et décrypter ensemble les dernières évolutions du domaine.
-
Le 6 juin à Châteauroux, L’IA, et le vivant dans tout ça ? propose une causerie autour de la place du vivant face au développement de l’intelligence artificielle.
-
Le 6 juin à Vigneux-sur-Seine, Découvrir l’I.A permet de tester des outils et d’échanger autour des usages de l’intelligence artificielle. Inscription : cafe-ia@culture-numerique.com
-
Le 11 juin à Grenoble, un Apéro IA propose un moment convivial pour découvrir les bases de l’IA, débattre de ses enjeux et partager ses questions sans prérequis technique.
-
Le 13 juin de 10h à 17h à la Maison de la culture d’Amiens dans le cadre du Festival de la région Hauts-de-France IA avec nous se tiendra une journée complète d’animation autour de l’IA : conférences, jeux d’enquêtes, escape game, mur de l’IA, ateliers et Cafés IA…
-
Le 16 juin à Sallertaine, un Café IA propose un moment d’échange autour du numérique et de l’intelligence artificielle.
-
Le 17 juin à Martigues, le Café IA : Comment bien utiliser les Intelligences Artificielles ? invite à expérimenter différents outils d’IA, de la conversation à la création d’images et de musique.
-
Le 18 juin à Seyssinet-Pariset, IA, biais et stéréotypes propose une conférence-débat sur les biais observés dans les systèmes d’intelligence artificielle et leur lien avec les représentations sociales.
-
Le 20 juin à Paris, le Café IA #5 - Partie 2 : Musique et droits d’auteur poursuit la réflexion sur la créativité à l’ère de l’IA générative, entre création musicale, propriété intellectuelle et pratiques artistiques.
Vous organisez un Café IA grand public ? Inscrivez vos sessions, ou découvrez les sessions proches de chez vous dans le recensement national et sur la cartographie interactive. |
🦓 Les Cafés Animation à venir !
|
Vous souhaitez animer un Café IA ou partager votre expérience ? Participez aux prochains cafés animations en ligne, le jeudi de 13h30 à 15h pour découvrir des formats d’animation, des ressources pédagogiques sur l’IA et faire part de vos retours d’expérience. Un moment convivial pour s’inspirer et apprendre ensemble ! |
Les prochains rendez-vous : -
Jeudi 11 juin : venez explorer la recette inratable, pour faire un café toujours réussi.
- Jeudi 18 juin : pas de café animation
-
Jeudi 25 juin : Animateurs, et si on faisait ensemble le bilan de la semaine de l’IA pour tous ? Une rencontre pour nous faire part de vos expériences, de ce qui a marché, de ce qui a moins fonctionné. Construisons le bilan de cette semaine de mobilisation ensemble.
|
🚄 Sur la route… avec la mission Café IA
|
|
|
|
Evolution des usages de l’IA |
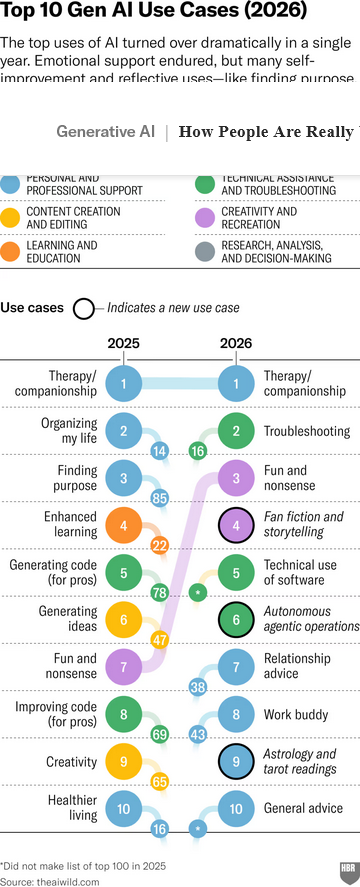
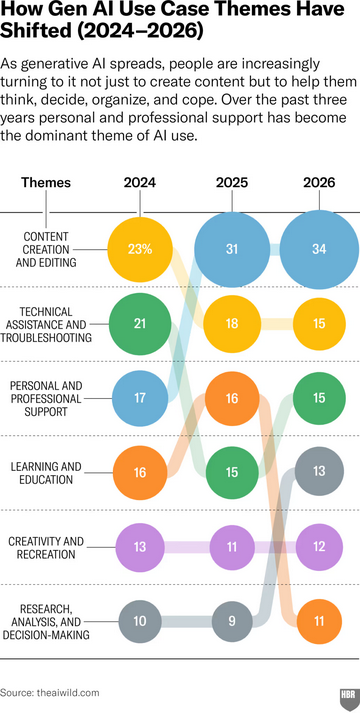
En septembre, à l’occasion d’une étude d’Open AI sur les usages des utilisateurs de ChatGPT, nous avions évoqué celle de Marc Zao-Sanders sur les 100 principaux cas d’utilisation de l’IA générative. Celui-ci vient de publier l’édition 2026 de son étude dans la Harvard Business Review. Malgré ses biais méthodologiques, l’étude tente de montrer l’évolution des pratiques d’une année sur l’autre. L’analyse ne montre pas de rupture, plus des tendances, des modes, comme par exemple le fait d’utiliser l’IA pour la lecture des tarots et de l’astrologie (!!). Pour Zao-Sanders, un quart des principaux cas d’utilisation consiste à demander à l’IA d’accomplir une partie des réflexions qu’ils ont à faire.
Si la thérapie/compagnie reste le principal cas d'utilisation de l’IA depuis que Zao-Sanders produit son étude (c’est-à-dire depuis 2024), les utilisations pratiques et de divertissement augmentent fortement en 2026. La résolution de problème grimpe de l'extérieur du top 10 en 2025 à la seconde place en 2026. L’utiliser pour le fun ou pour faire des choses absurdes reste dans le top 10, mais ne serait que le troisième usage de l’IA. D’ailleurs, nombre d’entrées dans le top 10 des usages sont de l’ordre du divertissement. Quelques pratiques sérieuses dominent comme la résolution de problème et le fait de l’utiliser pour utiliser d’autres logiciels.
|
Dans ce top 10 des usages, la créativité et la génération d’idées régressent. Comme les utilisations réflexives liées à l’amélioration de l’apprentissage. Peu à peu, une forme d’utilisation un peu paresseuse semble s’installer (mais qui n’est peut-être pas dû seulement aux utilisateurs, elle peut être aussi la conséquence des réponses inadaptées des outils).
Zao-Sanders livre de son étude une analyse morale : l’IA servirait de plus en plus à externaliser notre réflexion. Pour ma part, je lis plutôt dans l’évolution du top des catégories, une montée des usages récréatifs de l’IA, certainement parce qu’elle a montré aux utilisateurs qu’elle n’était pas toujours utile pour des usages sérieux. |
Dans son étude, Zao-Sanders montre que l’assistance technique qu’elle fournit régresse tout comme les usages d’apprentissages, alors que la création de contenus reste forte. « Nos données montrent également que les gens utilisent souvent l'IA pour améliorer leurs interactions humaines : dans ce contexte, les gens semblent préférer les caractéristiques non humaines de l'IA, y voyant un répit face au jugement humain ».
Enfin, souligne-t-il, les données montrent que l'utilisation de l'IA au travail est quelque peu chaotique. L’IA agentique et le vibe coding restent encore expérimentaux. Au travail, l’usage de l’IA est encore mal vécu et se fait encore souvent dans l’ombre. « On constate que l’IA est principalement utilisée pour obtenir des résultats modestes et consensuels, dans certains domaines, comme la vente, et très rarement pour repenser en profondeur les processus métier. » Dans le marketing, l'IA est utilisée pour développer l'activité, principalement pour produire de l’A/B testing. Pour l’instant, c’est le domaine où s’exprime le mieux un début de retour sur investissement, partout ailleurs, l’amélioration est plus souvent rapportée de manière anecdotique.
|
Podcasts génératifs : intimité synthétique |
La possibilité de générer un podcast automatiquement est l’une des fonctions phare de NotebookLM de Google. On y met des documents écrits, on appuie sur un bouton, et hop ! on obtient un fichier audio où deux voix synthétiques semblent discuter des contenus. La fonction est bluffante… Même si, personnellement, je doute que quiconque n’ait jamais écouté le résultat du début à la fin. La chercheuse Jill Walker Rettberg, du Centre d’étude de la narration numérique de l’université de Bergen a réalisé une étude de cette fonctionnalité, en y téléchargeant plusieurs contenus et en étudiant les résultats. Elle montre notamment que les podcasts, quels que soient les contenus, articulent un modèle d’émission assez fixe. Que toutes les productions sont moyennisées avec des commentateurs culturellement stéréotypés (des personnes blanches, éduquées et de classe moyenne…), bien loin de la réalité du podcast et de la radio, qui tiennent beaucoup d’animateurs qui s’adressent à des communautés spécifiques depuis des positions sociales plus ou moins variées.
Pour la chercheuse, les podcasts générés par l'IA utilisent des marqueurs de connexion qu’utilisent normalement les humains, c'est-à-dire des mots, des phrases, des vocalisations sans contexte, pour faire croire qu’ils semblent humains sans y parvenir. Une forme « d’intimité synthétique » assez factice qui sert à imiter le style des podcasts communautaires, « mais ils sont en réalité encore plus détachés de leur public que ne l'a été la diffusion radio de masse du XXe siècle ».
Hormis la tonalité, les deux voix sont très similaires. En fait, lorsque la chercheuse a utilisé le service de transcription IA Otter.ai pour transcrire les contenus, le logiciel s'est avéré incapable de distinguer les deux intervenants, alors qu'il est généralement très performant pour différencier les locuteurs humains. Le ton de la voix est peut-être la seule différence entre les deux animateurs. Ils alternent également de manière assez aléatoire entre explications et questions, et bien que l'un des deux puisse parler un peu plus que l'autre dans certains podcasts, leur temps de parole est quasiment identique sur l'ensemble des podcasts générés. Le format est très conversationnel, et les animateurs s'interrompent et se coupent constamment la parole, en utilisant des mots comme « hum », « d'accord », « ouais », « exactement ». Les podcasts jouent beaucoup sur l'idée d'approfondir un sujet. Ils reprennent également d'autres conventions du genre, comme le dialogue informel et enthousiaste où les animateurs s'interrompent mutuellement, et donnent l'impression de singer une relation de proximité entre eux et avec l'auditeur.
En décortiquant les propos, la chercheuse montre que ces outils génèrent beaucoup d’erreurs, notamment en ajoutant du contexte aux sources qui n’ont rien à voir avec elles, par exemple quand le podcast devait discuter de documents sur le fonctionnement des universités norvégiennes en ajoutant des considérations qui ne se retrouvent que dans le monde universitaire américain. Pour la chercheuse l’effet tient d’une homogénéisation sous forme d’un discours universalisant et intemporel, qui finit souvent par être décorrélé de ce qu’il est censé analyser.
Pour Rettberg, les productions de NotebookLM portent un rêve d’universalité qui fait partie de l’idéologie des grands modèles de langage. C’est le « tour de passe-passe divin » dénoncé par Donna Haraway dans Savoirs situés (1988, qui vient d’être traduit chez Wildproject), qui consiste à tout voir de nulle part, en masquant que ce regard est situé.
La radio pré-numérique était matériellement et culturellement située car elle était diffusée depuis un lieu précis et les auditeurs ne pouvaient recevoir les signaux que dans une certaine zone géographique, rappelle Rettberg en évoquant ses souvenirs d’étudiante où elle travaillait à la station de radio locale. Les podcasts créés par des humains ne sont pas ancrés dans le temps et l'espace, mais ils sont encore incarnés par des animateurs, qui parlent une langue spécifique,d'une manière spécifique, depuis un certain contexte. Celui des podcasts génératifs « est déterminé par les données d'entraînement et les modèles génératifs utilisés », qui sont d’abord ceux d’une langue et d’un monde américano-centré. Ils singent une intimité synthétique en la rendant superficielle, universelle… et plus encore désincarnée, détachée du social, où toute sphère publique est absente. Le podcast génératif n’est rien « d'autre qu'un flux privé qui va directement des entreprises à l'individu », court-circuitant toutes les autres sphères publiques existantes.
|
💥 La ressource de la semaine |
Numéville est un jeu de plateau coopératif de sensibilisation au numérique responsable à destination des adolescents. Les joueurs incarnent les Éclaireurs du Numérique, de jeunes héros déterminés à libérer leur ville de l’emprise du redoutable Dark Master qui tente de contrôler les habitants en diffusant de mauvaises pratiques numériques. Derrière les 200 questions du quizz auxquelles les joueurs doivent répondre, l’idée est d’apprendre des bonnes pratiques pour naviguer dans les réseaux.
Le mode plateau permet de jouer en famille ou entre amis, de 2 à 4 joueurs en une trentaine de minutes. Le mode atelier permet d’animer une classe entière.
Le projet, porté par l’Institut du Numérique Responsable est disponible en boîte à l’achat mais également à imprimer soi-même. |
Merci de nous avoir lus ! Si vous avez apprécié la lettre d’information de cette semaine, partagez-la ! Tout un chacun peut s’inscrire ici.
Comme d’habitude, n’hésitez pas à nous faire vos retours. Vous avez des questions, des remarques ou des suggestions ou vous souhaitez que nous abordions un sujet en particulier ? Nous sommes à votre écoute ! N’hésitez pas à répondre à ce mail ou à nous écrire à bonjour@cafeia.org. |
|
|
|
|